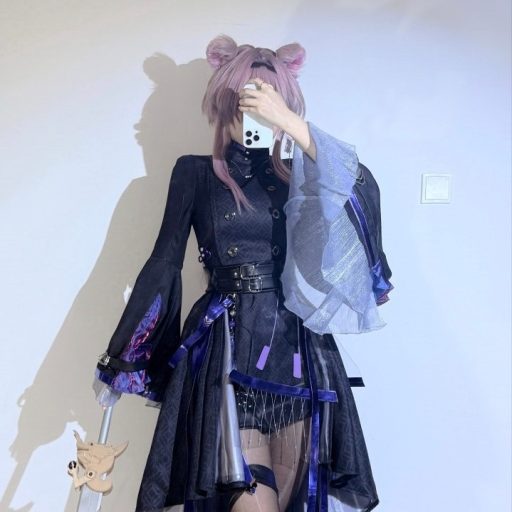
整理这个合集的时候,硬盘空间直接告警了两次。
艺图语这个系列在站内存放已经有段时间,早期零散分布在不同分类目录下,后期陆续补全了不少缺失期数。这次集中梳理出来,单纯统计文件夹数量就花了接近三个小时,脚本跑完显示11795个独立目录,总容量稳定在3.5TB左右,压缩包解压后实际占用空间还要再大一些。
合集构成与收录逻辑
按时间线排序,最早的期数可以追溯到2016年前后,后期更新频率保持在每周三到五期的节奏。整理过程中发现有几个明显的阶段性特征:
前2000期左右,图片规格多在2000像素宽度以内,JPG压缩质量参数不统一,部分早期源文件带有水印层。2000-6000期之间,拍摄规格明显升级,4000-6000像素宽度成为主流,RAW转档流程规范化,色彩管理更统一。6000期之后,8K分辨率源文件开始出现,单期解压后动辄15-30GB,这也是存储压力主要来源。
按拍摄题材分类,大致能划分为五大类:室内棚拍占比接近45%,外景街拍和旅拍各占20%左右,主题企划和特别刊合计15%。棚拍系列里又细分了灯光风格——高调柔光、低调轮廓、混合色温、自然光模拟等,每种风格下又有不同摄影师的个人习惯。
文件组织与命名规范

整理时重新建立了索引结构,采用「年份-期数-主题关键词-摄影师代号」的四级命名。比如「2023-09875-夏日海边胶片感-LX03」这种格式,既保留了原始期数序列,又便于按题材、摄影师、时间维度交叉检索。
元数据层面,把每期的EXIF信息、拍摄参数、模特标签、场景分类单独导出建立了SQLite索引库,约420万条记录。这样后续需要查「85mm定焦+自然光+逆光」这类组合条件时,不需要遍历文件系统。

压缩包采用分卷压缩,单卷不超过4GB,配合SHA256校验文件。考虑到3.5TB数据传输的不确定性,还生成了基于Merkle树的断点续传索引,网络中断后能精确定位到损坏的分卷块。
浏览体验与使用建议
实际浏览时建议配合图片管理软件使用,比如Eagle、Billfish这类支持离线缩略图的工具。直接用系统自带查看器逐个打开11795个文件夹不现实,建立本地缩略图库大概需要6-8小时,但之后检索、筛选、收藏操作都在秒级响应。

存储介质方面,机械硬盘阵列(RAID5/6)是性价比首选,但随机读取性能会成为瓶颈。条件允许的话,建议把索引库和缩略图放在NVMe SSD上,源文件留在HDD阵列,读写分离能显著改善浏览流畅度。
对于只关注特定题材的用户,不必全量下载。索引库支持导出期数清单,按标签筛选后生成aria2下载列表,按需获取单期或批量期数,带宽和存储压力都能大幅降低。

整理过程中的异常处理
梳理过程中遇到过几类典型问题:

约3%的期数存在重复收录,文件名不同但内容一致,通过感知哈希去重清理掉了约340期。另有1.2%期数文件损坏或缺失关键帧,标记在异常清单里,后续有补档渠道时再回填。
早期部分期数的模特身份信息缺失,只能通过面部特征聚类辅助标注,准确率在85%左右,已在索引字段标注置信度等级,使用时可自行判断。
色彩空间不统一是老合集常见问题,sRGB、Adobe RGB、ProPhoto RGB混用,部分文件甚至未嵌入ICC配置文件。批量处理时统一转换为sRGB并嵌入标准配置,避免不同查看器显示差异。
后续维护计划
这个合集不会是最终版。按目前更新节奏,每季度会有150-200期新增内容。计划建立增量同步机制:新增期数单独打包,索引库增量更新,校验文件追加模式生成,避免每次全量重新分发。
前往查看: 艺图语写真图片合集打包下载11795期 3.5TB
同时在尝试引入AI辅助标注——场景分类、构图类型、灯光模式、色调风格等维度自动打标,人工复核后写入索引。如果准确率能稳定在90%以上,后续检索维度会更丰富。
存储端考虑引入冷热分层:近两年高频访问的期数保留在热存储,早期低频访问数据迁移到归档存储,按需召回。3.5TB规模下,分层策略能节省约40%的存储成本。

---
整理记录到这儿。索引库、校验文件、下载清单模板都在合集根目录的`_index`文件夹里,解压前先核对清单,解压后跑一遍校验脚本,省得后面发现缺卷重下。